
在整个教程中,我们会使用这个简单的数据集  。如果把第四列作为标签,那么第三列就是特征;如果把第三列作为标签,那么第四列就是特征。
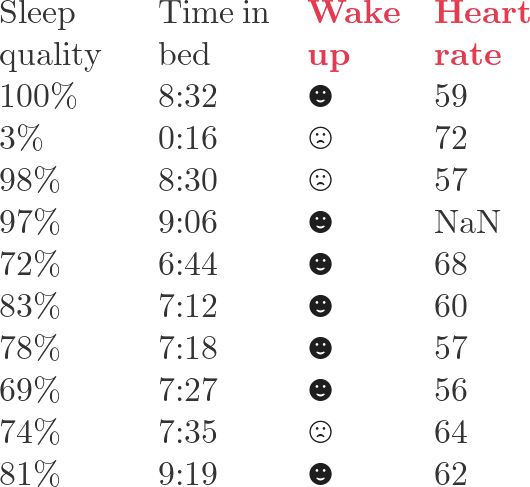
Table of Contents
本文会推导什么
- 为什么平方误差提升会拟合残差。
- 为什么逻辑损失的梯度是
p-y,Hessian 是p(1-p)。 - XGBoost 如何得到正则化叶子权重
-G / (H + lambda)。 - 分裂增益如何从叶子目标函数推出,并用一个简短的 NumPy 示例验证。
Boosting
Boosting 是一种加性建模策略。我们不是一次性训练一个复杂模型,而是按顺序训练许多简单模型。每个新模型都试图修正当前集成模型仍然预测错误的部分。
把第 m 步之后的预测写成
其中 F_{m-1} 是当前模型,f_m 是新的弱学习器,eta 是学习率。在树提升中,f_m 通常是一棵回归树。关键思想是,这棵树并不直接学习原始目标;它学习的是当前预测应该移动的方向。
对于平方误差回归,这个方向很容易看出:
因此负梯度是
这正是残差。这也是为什么可以把梯度提升介绍为“让下一棵树拟合残差”。对于其他损失函数,同样的思想仍然成立,只是残差变成了由梯度推导出的伪残差。
用于回归的 Gradient Boost
梯度提升的损失函数可以写成
这里 hat{y}_i^{(t-1)} 是加入新树之前的预测,f_t(x_i) 是新树给出的更新,Omega(f_t) 是正则化项。为了建立直觉,先忽略正则化:
对于平方误差,
它对当前预测的导数是
因此负梯度是
这恰好就是残差。所以一次回归 boosting 迭代可以写成:
- 使用当前集成模型进行预测。
- 计算残差或负梯度。
- 训练一棵新树去拟合这些残差。
- 把这棵树加入集成模型,通常还会乘上一个学习率。
这解释了从普通残差拟合到梯度提升之间的桥梁:残差是负梯度的一个特殊情况。
用于分类的 Gradient Boost
说明:为了避免符号过重,下面有时会省略求和符号 sum。这里的推导针对二分类。
对于一个二分类问题,把赔率定义为
概率为
通过简单代数变形,
这就是作用在对数赔率上的 logistic sigmoid。令
则
使用二元交叉熵作为损失函数:
我们希望找到使损失最小的 gamma:
我们可以直接处理损失函数并求解
但这样会变得繁琐。二阶泰勒近似可以给出更清晰的更新方式。在当前得分 F_{m-1} 附近,
其中
令它对 gamma 的导数为零:
得到
所以最优的局部更新为
对于二元交叉熵,它对 F = log(text{odds}) 的一阶导数为
配合一些示意:
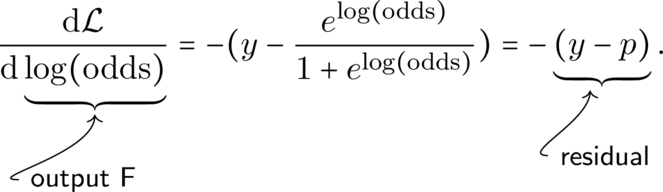
mathcal{L} 对 log(text{odds}) 的二阶导数是
因此,对于一个观测值,
对于包含多个观测值的叶子节点,Newton 风格的更新会聚合梯度和 Hessian:
这就是从梯度提升分类到 XGBoost 的实用桥梁。
XGBoost
XGBoost 保留了加性树模型,但把目标函数写得更明确,并加入正则化。在第 t 轮 boosting 中,它按照下面的目标函数加入一棵新树。
下面的记号遵循 XGBoost 论文中的目标函数和官方提升树教程。本文保留中间代数步骤,方便你自行复现结果,而不是只记住最终公式。
其中树的正则化通常写作
这里 T 是叶子数量,w_j 是第 j 个叶子的分数,gamma 惩罚新增叶子,lambda 是作用在叶子权重上的 L2 正则化。
使用二阶泰勒近似,
其中
对于一个固定的树结构,每个样本都会落入某个叶子。令 I_j 表示落入第 j 个叶子的样本集合,并定义
第 j 个叶子的目标函数变为
因此最佳叶子权重为
这就是 XGBoost 版本的 -g/h 更新。正则化项 lambda 可以在 Hessian 很小时防止叶子分数变得过大。
对应的树结构评分为
当把一个叶子拆分为左、右两个子节点时,XGBoost 会评估增益:
当这个增益为正,并且足够大到可以证明额外复杂度是值得的,这次分裂就是有用的。这也是为什么 XGBoost 不只是“带树的梯度提升”;它是带有二阶信息、显式叶子评分和正则化分裂选择的梯度提升。
在 Python 中检查这些思想的一个最小方式是:
import numpy as np

# Binary labels and current probabilities from the current ensemble.
y = np.array([1, 0, 0, 1, 1], dtype=float)
p = np.array([0.55, 0.40, 0.48, 0.70, 0.62], dtype=float)

# Logistic-loss gradient and Hessian with respect to the log-odds score F.
g = p - y
h = p * (1 - p)

lambda_l2 = 1.0
leaf_weight = -g.sum() / (h.sum() + lambda_l2)

print(g)
print(h)
print(leaf_weight)
具体数值取决于当前预测,以及哪些样本落入这个叶子。公式本身是稳定的:计算梯度,计算 Hessian,按叶子聚合它们,然后使用 -G / (H + lambda)。
下一步练习
如果你已经能够自行推导 -G / (H + lambda),但还想进行结构化的实现练习,DataCamp 的 Extreme Gradient Boosting with XGBoost 课程会继续讲解分类、回归、超参数调优和 scikit-learn 流水线。它适合作为实践的下一步,但不是上面数学推导的来源。
截至 2026-09-02,这是一条普通的非联盟课程链接。如果 LazyingArt 日后获准加入 DataCamp 联盟计划,任何带跟踪的替代链接都会被清楚标注,并与这条普通链接并列保留。
参考
- Jerome H. Friedman. “Greedy Function Approximation: A Gradient Boosting Machine.” The Annals of Statistics 29, no. 5 (2001). https://doi.org/10.1214/aos/1013203451
- Tianqi Chen and Carlos Guestrin. “XGBoost: A Scalable Tree Boosting System.” Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (2016). https://doi.org/10.1145/2939672.2939785
- XGBoost 开发者. “Introduction to Boosted Trees.” https://xgboost.readthedocs.io/en/stable/tutorials/model.html
- Dana D. “Sleep Data: Personal Sleep Data from Sleep Cycle iOS App.” Kaggle. https://www.kaggle.com/danagerous/sleep-data