
このチュートリアル全体では、この単純なデータセット  を使います。4列目をラベルとして使うなら3列目が特徴量になり、3列目をラベルとして使うなら4列目が特徴量になります。
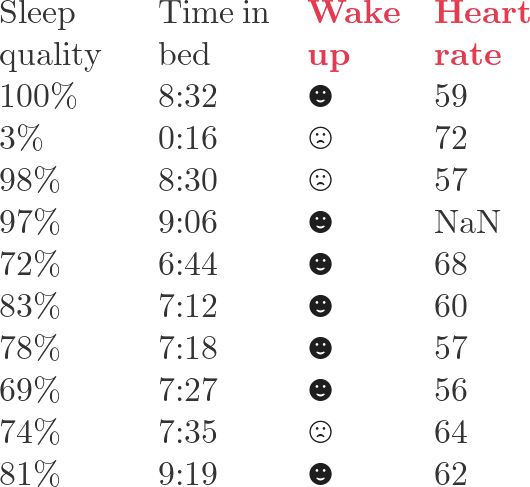
Table of Contents
このガイドで導出すること
- 二乗誤差ブースティングが残差を学習する理由。
- ロジスティック損失の勾配が
p-y、ヘッセ行列成分がp(1-p)になる理由。 - XGBoostが正則化された葉重み
-G / (H + lambda)を得る過程。 - 葉の目的関数から分割ゲインを導き、小さなNumPy例で確認する方法。
Boosting
ブースティングは加法的なモデリング戦略です。複雑なモデルを一度に1つ学習するのではなく、多数の単純なモデルを順番に学習します。新しい各モデルは、現在のアンサンブルがまだ間違えている部分を修正しようとします。
ステップ m 後の予測を次のように書きます。
ここで F_{m-1} は現在のモデル、f_m は新しい弱学習器、eta は学習率です。木ブースティングでは、f_m は通常、回帰木です。重要なのは、この木が元の目的変数を直接学習するのではなく、現在の予測をどちらの方向へ動かすべきかを学習するという点です。
二乗誤差回帰では、この方向は簡単に確認できます。
したがって負の勾配は
これはまさに残差です。これが、勾配ブースティングを「次の木を残差にフィットさせる」と導入できる理由です。他の損失関数でも同じ考え方は機能しますが、その場合の残差は勾配から導かれる擬似残差になります。
Gradient Boost for Regression
勾配ブースティングの損失関数は次のように書けます。
ここで hat{y}_i^{(t-1)} は新しい木を追加する前の予測、f_t(x_i) は新しい木による更新、Omega(f_t) は正則化項です。直感をつかむため、まず正則化は無視します。
二乗誤差では、
現在の予測に関する微分は
したがって負の勾配は
これは正確に残差です。したがって回帰ブースティングの1回の反復は次のようになります。
- 現在のアンサンブルで予測する。
- 残差または負の勾配を計算する。
- その残差に新しい木をフィットさせる。
- 通常は学習率を掛けて、その木をアンサンブルに追加する。
これにより、通常の残差フィッティングから勾配ブースティングへの橋渡しが説明できます。残差は負の勾配の特殊な場合なのです。
Gradient Boost for Classification
注意: 記法が重くなるのを避けるため、以下では総和記号 sum を省略することがあります。導出は二値分類を対象としています。
二値分類問題では、オッズを次のように定義します。
確率は
簡単な代数により、
これはロジット、つまり対数オッズにロジスティックシグモイドを適用したものです。次のように置きます。
すると、
損失として二値交差エントロピーを使います。
損失を最小化する gamma を見つけたいとします。
損失を直接扱って
を解くこともできますが、これは煩雑になります。2次のテイラー近似を使うと、更新がより明快になります。現在のスコア F_{m-1} の周りで、
ここで、
gamma に関する微分をゼロにします。
これにより、
となるので、局所的な最適更新は
二値交差エントロピーでは、F = log(text{odds}) に関する1階微分は
少し図示すると、
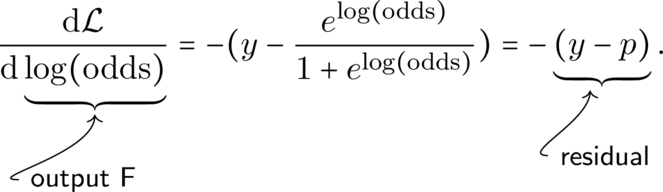
log(text{odds}) に関する mathcal{L} の2階微分は
したがって、1つの観測値については、
多くの観測値を含む葉では、ニュートン法風の更新は勾配とヘッセ行列成分を集約します。
これが、分類の勾配ブースティングからXGBoostへの実践的な橋渡しです。
XGBoost
XGBoostは加法的な木モデルを維持しつつ、目的関数をより明示的かつ正則化された形にします。ブースティングラウンド t では、次の目的関数に基づいて新しい木を追加します。
以下の記法は、XGBoost論文の目的関数と公式のブースト木チュートリアルに従っています。最終式を暗記するのではなく再現できるよう、中間の代数も示します。
ここで木の正則化は一般に次のように書かれます。
ここで T は葉の数、w_j は葉 j のスコア、gamma は葉を追加することへのペナルティ、lambda は葉の重みに対するL2正則化です。
2次のテイラー近似を使うと、
ここで、
固定された木構造では、各サンプルは1つの葉に入ります。I_j を葉 j に含まれるサンプル集合とし、次のように定義します。
葉 j の目的関数は
したがって最良の葉重みは
これは -g/h 更新のXGBoost版です。正則化項 lambda は、ヘッセ行列成分が小さいときに葉スコアが非常に大きくなるのを防ぎます。
対応する木構造のスコアは
1つの葉を左右の子に分割するとき、XGBoostは次のゲインを評価します。
このゲインが正で、追加の複雑さを正当化できるほど十分に大きい場合、その分割は有用です。これが、XGBoostが単なる「木を使った勾配ブースティング」ではない理由です。XGBoostは、2階情報、明示的な葉スコアリング、そして正則化された分割選択を備えた勾配ブースティングなのです。
Pythonでこれらの考え方を最小限に確認する方法は次のとおりです。
import numpy as np

# Binary labels and current probabilities from the current ensemble.
y = np.array([1, 0, 0, 1, 1], dtype=float)
p = np.array([0.55, 0.40, 0.48, 0.70, 0.62], dtype=float)

# Logistic-loss gradient and Hessian with respect to the log-odds score F.
g = p - y
h = p * (1 - p)

lambda_l2 = 1.0
leaf_weight = -g.sum() / (h.sum() + lambda_l2)

print(g)
print(h)
print(leaf_weight)正確な数値は、現在の予測と、どのサンプルがその葉に入るかに依存します。式は安定しています。勾配を計算し、ヘッセ行列成分を計算し、それらを葉ごとに集約してから、-G / (H + lambda) を使います。
次の練習
-G / (H + lambda) の導出を自分で再現でき、さらに体系的な実装練習をしたい場合は、DataCamp の Extreme Gradient Boosting with XGBoost コースで、分類、回帰、ハイパーパラメータ調整、scikit-learn パイプラインへ進めます。これは実践の次の一歩であり、上の導出の出典ではありません。
2026-09-02 現在、これは通常の非アフィリエイトリンクです。今後 LazyingArt が DataCamp のアフィリエイトプログラムに承認された場合も、トラッキング付きの代替リンクは明確に表示し、この通常リンクと並べて残します。
参考文献
- Jerome H. Friedman. “Greedy Function Approximation: A Gradient Boosting Machine.” The Annals of Statistics 29, no. 5 (2001). https://doi.org/10.1214/aos/1013203451
- Tianqi Chen and Carlos Guestrin. “XGBoost: A Scalable Tree Boosting System.” Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (2016). https://doi.org/10.1145/2939672.2939785
- XGBoost開発者. “Introduction to Boosted Trees.” https://xgboost.readthedocs.io/en/stable/tutorials/model.html
- Dana D. “Sleep Data: Personal Sleep Data from Sleep Cycle iOS App.” Kaggle. https://www.kaggle.com/danagerous/sleep-data